在自己的座位01
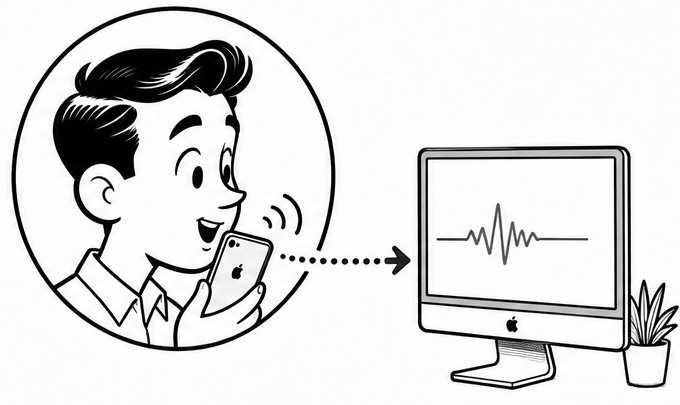
Prompt 不必說給整間辦公室聽
修改方向、錯誤訊息或邊界條件,用很小的聲音說清楚就好。旁邊的人不用加入這場對話。
在辦公室也能放心開口
用 undervoice,你可以把還沒公開的點子說出來,不必擔心整間辦公室都聽見,也不用尷尬地在同事面前念 Prompt。對著 iPhone 輕聲說,Mac 會在本機轉成文字,直接輸入游標所在的位置。
01 / 運作方式
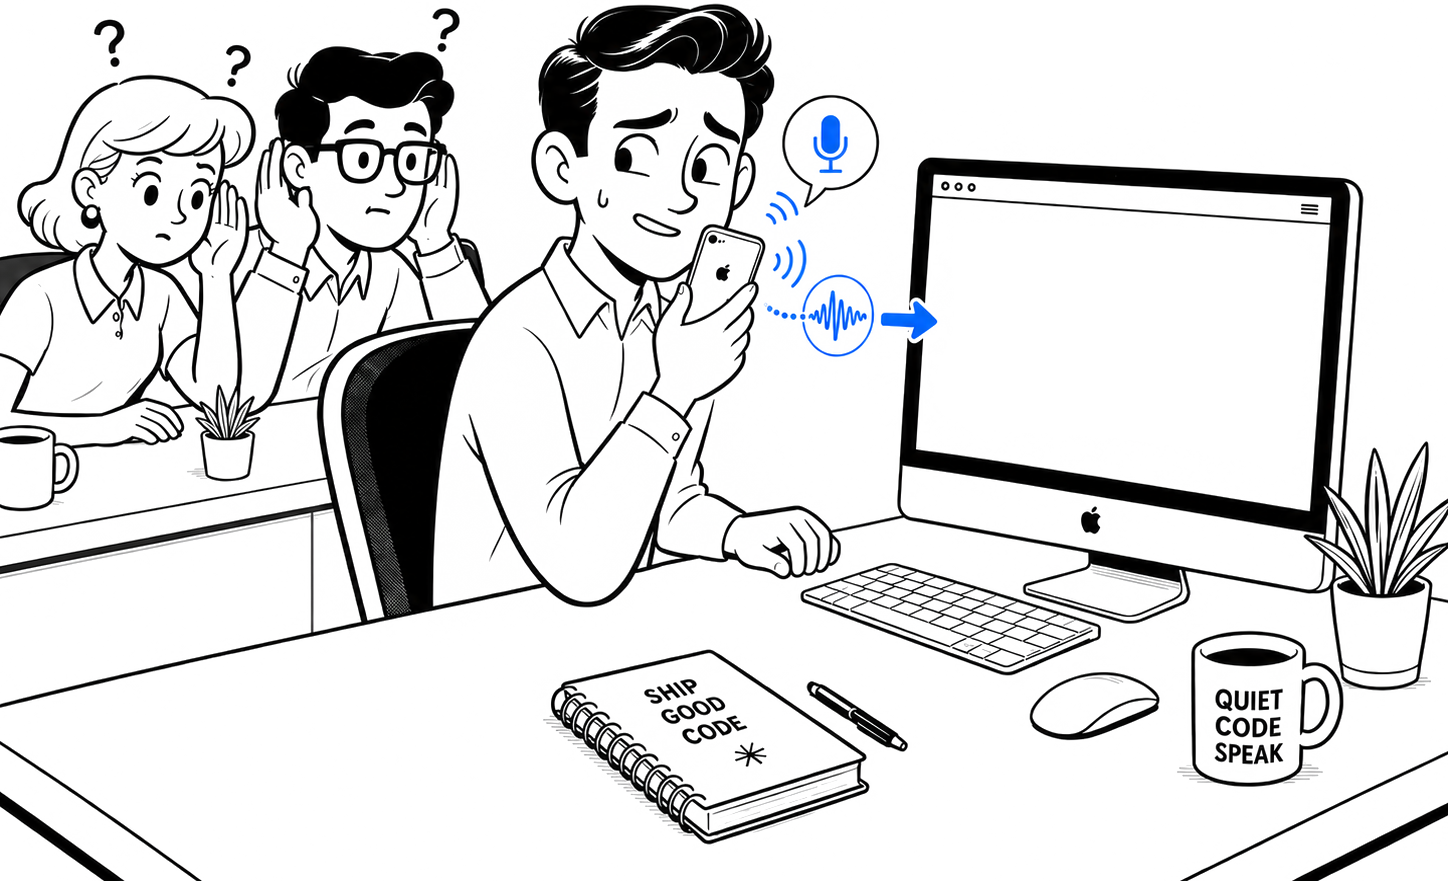
undervoice 不用桌面另一端的 Mac 收音,而是直接使用你手上的 iPhone。麥克風離嘴巴更近,你的聲音會比鍵盤、空調和周圍對話更早、更清楚地被收到。就算輕聲說,Mac 上的本機辨識也能取得乾淨的聲音。
IPHONE → MAC / 實際用起來
iPhone 負責近距離收音。加密音訊直接傳到已配對的 Mac,在本機辨識後輸入目前的游標位置。
ScenicRouteRanker.swift
修改方向、錯誤訊息或邊界條件,用很小的聲音說清楚就好。旁邊的人不用加入這場對話。
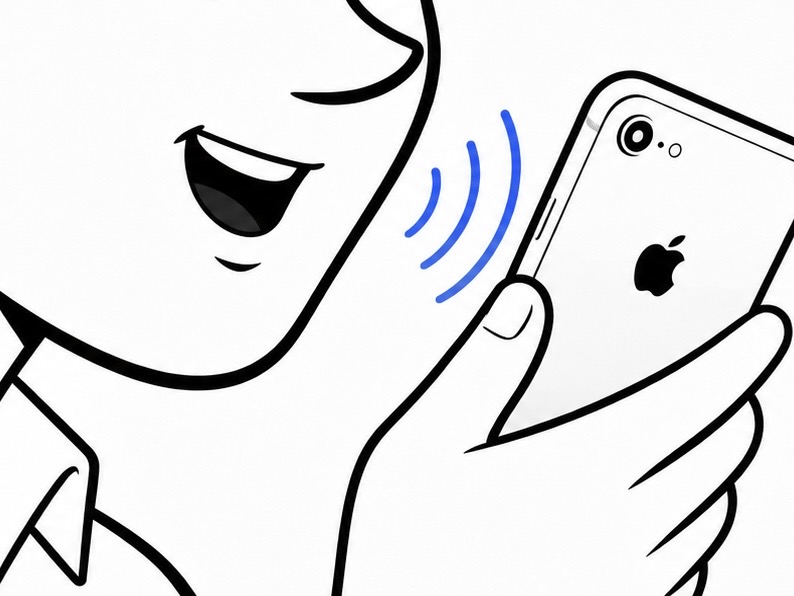
近講不會讓辦公室安靜下來,但能在辨識開始之前,先讓人聲比環境音更清楚。
畫面留在 Codex、Claude Code、Xcode、Terminal 或瀏覽器,辨識結果直接進到游標。
02 / 真正影響使用的數字
能說多小聲、音訊去了哪裡、說完還要不要搬文字,這些才是每天用起來真正有感的差異。
iPhone 可以拿到嘴邊;MacBook 繼續放在桌上,通常還有 50–80 cm 的距離。
這是單純用 5–10 cm 與 50–80 cm 距離估算的結果。空間、持機角度和麥克風都會影響實際值。
辨識在你的 Mac 上完成。模型準備好之後,在區網使用不需要連上公網。
音訊只在記憶體中處理並釋放,不會在 iPhone 或 Mac 留下錄音檔。
不用開另一個 App、複製,再切回開發工具;結果直接進目前的輸入欄。
記錄也能完全關閉,而且不會同步到 undervoice 伺服器。
03 / 中文語音辨識
中文不是一長串支援語言裡的其中一項。undervoice 圍繞中文 Prompt 配置辨識流程,也把自然出現在句子裡的英文函式庫名稱、API、變數與指令當成明確的使用情境。
雙語串流模型先提供即時預覽,再由 Paraformer 或準確度優先的 FireRedASR2 CTC 產生最終文字;中文標點也在 Mac 本機補齊。
函式庫名稱、API、變數、指令與縮寫可以自然混進中文,不必在說到一半時切換語言模式,也不需要交給另一套雲端模型。
中文語言包、即時預覽、最終辨識、標點與本機執行設定被當成同一條中文工作流程設計;中英混合句子也是明確處理的情境,而不是拿其他語言模型的數字替中文辨識背書。
04 / IPHONE 與 MACBOOK 麥克風
兩種方式都能使用 Mac 上相同的本機模型。真正不同的是,聲音從嘴邊幾公分開始,還是從桌面的另一端開始。
| 共享辦公情境 | iPhone 拿到嘴邊 | MacBook 內建麥克風 |
|---|---|---|
| 嘴巴到麥克風 | 5–10 cm | 50–80 cm |
| 輕聲說話時 | 你的聲音先明顯進入麥克風 | 人聲、鍵盤、空調和旁人對話一起進來 |
| 需要的音量 | 可以維持小聲 | 桌面距離通常得說得更大聲 |
| 辨識位置 | 你的 Mac 本機 | 你的 Mac 本機 |
| 最適合 | 開放式辦公室、共享座位 | 獨立空間,或不介意內容被聽見時 |
14–24 dB 是用自由音場公式 20 × log10(r₂/r₁),比較 5–10 cm 與 50–80 cm 的估算值。空間反射、持機位置和說話方向都會改變實際結果。
05 / 安全性與網路
undervoice 沒有語音中繼伺服器。在同一個網路裡,iPhone 會直接連到 Mac;跨網路時也能使用你自己的 Tailscale。不論走哪條路,App 層級的裝置驗證與加密都會保留。
查看安裝與權限說明 →連到同一個 Wi-Fi 還不夠。換新 iPhone 時,必須明確重新配對。
音訊、文字與控制訊息都會驗證身分並進行端對端加密。
重新連線時會衍生新的工作階段金鑰。
錄音只存在記憶體。診斷資訊不包含音訊或轉寫內容。
在區域網路中,音訊從 iPhone 直達 Mac,模型也在 Mac 上執行。
不同 Wi-Fi 或行動網路時,可使用自己的 Tailscale;undervoice 的加密仍會保留。
06 / 輸入到任何地方
「保留現有 API,把重試改成指數退避,再補三個邊界條件測試。」
正在聆聽開始說話時,Mac 會記住目前的 App 和文字選取範圍。辨識期間如果焦點改變,輸入會暫停;密碼欄與啟用 Secure Keyboard Entry 的控制項永遠不會被寫入。
跟 MAC 說,不用說給整間辦公室聽
先在 Mac 安裝模型,再用 iPhone 掃描配對碼。接下來,只要按住就能說。